Imagina que estamos construyendo una plataforma de datos para una empresa con miles de clientes.
Tenemos una tabla bastante sencilla: el identificador del cliente, su nombre, la región a la que pertenece y su esTodo funciona perfectamente hasta que alguien del equipo de negocio nos hace una pregunta:
«¿Cuántos clientes teníamos en cada región hace tres meses?»
En principio parece fácil. Abrimos nuestra tabla de clientes, hacemos un GROUP BY y listo.
Pero hay un pequeño problema: la tabla solamente contiene la información actual.
Si Ana vivía en Madrid en enero y se trasladó a Bilbao en marzo, nuestra tabla ya no conserva ese dato. Para ella, Madrid nunca existió.
Y puede que esto no sea especialmente grave para determinadas consultas, pero imaginemos que estamos calculando ventas históricas, comisiones comerciales o métricas financieras. Utilizar la región actual de un cliente para analizar operaciones de hace seis meses puede producir resultados incorrectos.
Aquí es donde entran las Slowly Changing Dimensions (SCD) y, en particular, las de tipo 2.
Hasta ahora, implementarlas en Spark implicaba escribir nuestra propia lógica para detectar cambios, cerrar registros antiguos, insertar nuevas versiones y controlar eventos que podían llegar duplicados o fuera de orden.
Con la llegada de Apache Spark 4.3, publicado el 30 de octubre de 2026, tenemos una alternativa bastante interesante: Auto CDC con soporte para SCD Type 2, integrado en Spark Declarative Pipelines.
Vamos a ver cómo funciona y qué nos ahorra realmente.
1. El problema: cuando actualizar un registro significa perder información
Supongamos que tenemos esta tabla:
| customer_id | name | region | status |
|---|---|---|---|
| 17 | Ana | Norte | activo |
| 23 | Luis | Centro | activo |
Ana cambia de región y recibimos un nuevo registro:
{
  "customer_id": 17,
  "name": "Ana",
  "region": "Sur",
  "status": "activo"
}
En un modelo tradicional de tipo 1 (SCD Type 1), actualizaríamos directamente su información.
UPDATE dim_clientes
SET region = 'Sur'
WHERE customer_id = 17;
Nuestro resultado sería:
| customer_id | name | region | status |
|---|---|---|---|
| 17 | Ana | Sur | activo |
| 23 | Luis | Centro | activo |
Perfecto, siempre que solamente nos interese el último estado.
Pero si queremos conservar el historial, necesitamos otro enfoque.
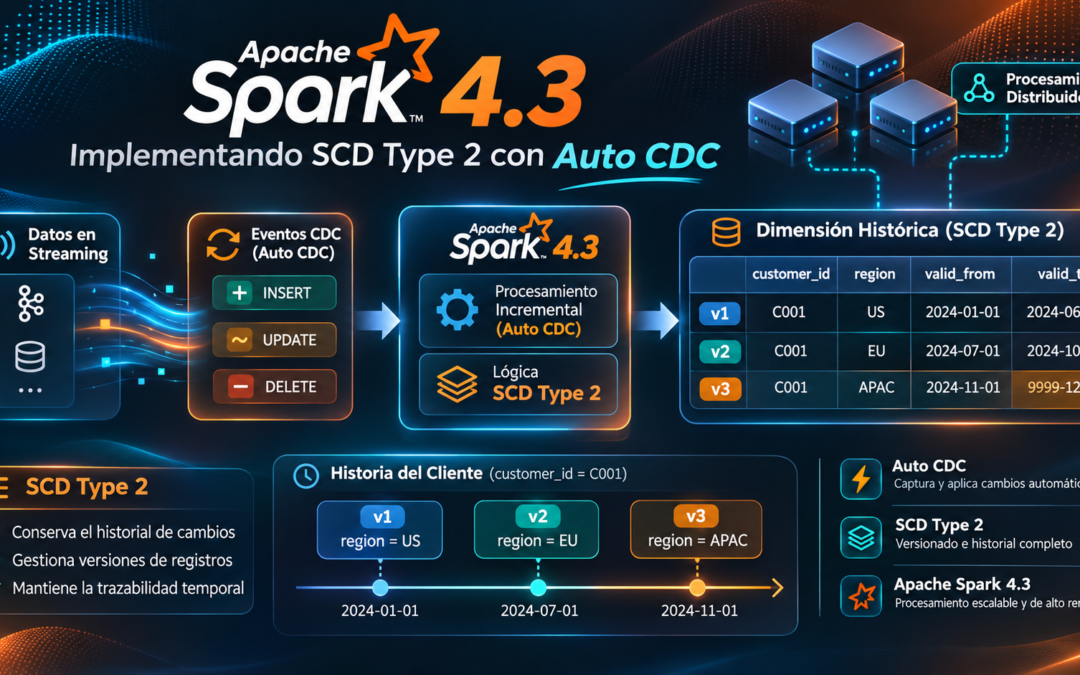
Con SCD Type 2, en lugar de sobrescribir el registro, mantenemos varias versiones del mismo cliente, cada una con un intervalo de validez.
| customer_id | region | valid_from | valid_to |
|---|---|---|---|
| 17 | Norte | 10 | 30 |
| 17 | Sur | 30 | NULL |
En este ejemplo, valid_from y valid_to representan números de secuencia, no fechas. El funcionamiento es el mismo que si utilizáramos timestamps.
La primera versión es válida desde la secuencia 10 hasta la 30, sin incluir esta última. A partir de la 30, Ana pertenece a la región Sur.
De esta forma podemos reconstruir cómo era nuestra información en un momento determinado.
El concepto es sencillo. El problema aparece cuando tenemos que mantener esas versiones automáticamente.
2. ¿Qué introduce Auto CDC en Spark 4.3?
Auto CDC es una funcionalidad de Spark Declarative Pipelines (SDP) que permite procesar eventos de Change Data Capture sin tener que implementar manualmente toda la lógica de actualización del destino.
El soporte para SCD Type 1 ya estaba disponible en Spark 4.2. La novedad de Spark 4.3 es poder mantener también el historial mediante SCD Type 2.
Para entenderlo, imaginemos que los cambios de nuestra tabla de clientes llegan desde PostgreSQL mediante Debezium y Kafka.
Cada vez que un cliente se crea, se modifica o se elimina, recibimos un evento.
Estos eventos tienen, como mínimo, tres elementos importantes:
- Una clave, para identificar a qué registro pertenece el cambio.
- Una secuencia, para determinar en qué orden se produjeron las modificaciones.
- Una operación, para distinguir las actualizaciones de las eliminaciones.
Auto CDC utiliza esta información para mantener una tabla de destino con el historial de cada clave.
Y aquí viene una de las partes más interesantes: los eventos no tienen por qué llegar en el mismo orden en el que ocurrieron.
Supongamos que Ana ha pasado por tres regiones:
Secuencia 10: Norte
Secuencia 20: Este
Secuencia 30: Sur
Sin embargo, nuestro sistema recibe los cambios en este orden:
1. Llega Norte (10)
2. Llega Sur   (30)
3. Llega Este  (20)
Un procesamiento ingenuo podría dejar a Ana en la región Este, simplemente porque fue el último mensaje recibido.
Auto CDC utiliza el valor de secuencia para reconstruir el historial en su posición correcta.
En SCD Type 2, el evento tardío de la secuencia 20 no se descarta por ser antiguo: se introduce entre las versiones 10 y 30.
Eso es bastante útil cuando trabajamos con sistemas distribuidos en los que el orden de llegada de los mensajes no está garantizado.
3. Vamos a construir nuestro ejemplo con PySpark
Vamos a utilizar un conjunto de eventos JSON que simulará los cambios recibidos desde una base de datos.
Nuestra arquitectura será bastante sencilla:
Archivos JSON (eventos CDC)
             |
             v
    Spark Structured Streaming
             |
             v
    Spark Declarative Pipelines
             |
             v
          Auto CDC
             |
             v
    Tabla SCD Type 2
En producción podríamos sustituir los archivos JSON por un topic de Kafka, pero para entender el funcionamiento nos basta con una fuente de archivos.
Preparando el entorno
Necesitamos Apache Spark 4.3 y las dependencias de Declarative Pipelines:
pip install "pyspark[pipelines]==4.3.0"Podemos crear la estructura inicial de nuestro proyecto:
spark-pipelines init --name demo_scd2
cd demo_scd2
La estructura tendrá un archivo spark-pipeline.yml, donde definiremos la configuración, y un directorio transformations, donde escribiremos la lógica.
El proyecto generado también puede incluir transformaciones de ejemplo, que podemos retirar para centrarnos en nuestra pipeline.
Hay un requisito importante antes de continuar.
Auto CDC necesita una tabla de destino que soporte operaciones a nivel de fila mediante Data Source V2, incluida la interfaz SupportsRowLevelOperations.
No basta con guardar los datos en Parquet. Spark utiliza internamente operaciones MERGE para mantener el destino y necesita un conector compatible.
Apache Iceberg es una opción natural para esta arquitectura, pero debemos comprobar que su conector sea compatible con Spark 4.3 y soporte las interfaces requeridas. No todos los conectores que permiten ejecutar un MERGE INTO son necesariamente compatibles con Auto CDC.
Por tanto, el siguiente ejemplo muestra la definición de la pipeline y los resultados esperados según el comportamiento documentado de Spark. Para ejecutarlo de extremo a extremo necesitamos configurar un catálogo persistente y un conector compatible.
Definiendo el esquema de nuestros eventos
Creamos el archivo transformations/clientes_cdc.py.
from pyspark import pipelines as dp
from pyspark.sql.types import (
    StructType,
    StructField,
    IntegerType,
    StringType,
    LongType
)

event_schema = StructType([
    StructField("customer_id", IntegerType()),
    StructField("name", StringType()),
    StructField("region", StringType()),
    StructField("status", StringType()),
    StructField("version", LongType()),
    StructField("op", StringType())
])
Cada evento tendrá el identificador del cliente, sus atributos, un número de secuencia y el tipo de operación (UPSERT o DELETE).
Utilizaremos version para ordenar los cambios. En una arquitectura real podríamos emplear un número de transacción, un offset apropiado del sistema de origen o una combinación de timestamp y secuencia.
Lo importante es que el valor permita establecer un orden determinista de cambios para cada cliente.
Leyendo los eventos en streaming
Añadimos una tabla de entrada:
@dp.table
def eventos_cdc():
    return (
        spark.readStream
        .schema(event_schema)
        .json("file:///tmp/demo_scd2/eventos")
    )
Aquí estamos utilizando @dp.table para registrar un dataset dentro de nuestra pipeline.
El uso de readStream indica que queremos procesar los nuevos eventos de forma incremental.
En este caso, cada archivo JSON nuevo que aparezca en el directorio será una fuente adicional de eventos.
Creando nuestra tabla SCD Type 2
Ahora viene la parte interesante.
dp.create_streaming_table(
    name="dim_clientes",
    format="iceberg"
)

dp.create_auto_cdc_flow(
    target="dim_clientes",
    source="eventos_cdc",
    keys=["customer_id"],
    sequence_by="version",
    apply_as_deletes="op = 'DELETE'",
    except_column_list=["op"],
    stored_as_scd_type=2,
    track_history_column_list=["region", "status"]
)
El formato iceberg es ilustrativo: requiere que tengamos instalado y configurado un conector compatible con esta versión de Spark.
Bastante menos código del que necesitaríamos para construir una SCD Type 2 manualmente.
Vamos a analizar los parámetros.
target y source
Indican dónde recibimos los eventos y qué tabla queremos mantener actualizada.
keys=["customer_id"]
Es nuestra clave de negocio. Todos los eventos que compartan el mismo identificador representan cambios de un mismo cliente.
sequence_by="version"
Probablemente el parámetro más importante.
Determina el orden lógico de los cambios. Auto CDC lo utiliza para gestionar eventos que llegan desordenados y reconstruir correctamente el historial.
apply_as_deletes="op = 'DELETE'"
Identifica los eventos que representan una eliminación.
En SCD Type 2, una eliminación no borra todo el historial del cliente. Cierra la versión correspondiente, conservando los datos anteriores.
stored_as_scd_type=2
Activa el mantenimiento del historial. Si utilizáramos el valor 1, conservaríamos únicamente el estado actual del registro.
track_history_column_list=["region", "status"]
Estamos indicando que queremos generar una nueva versión histórica cuando cambie la región o el estado del cliente.
No siempre interesa crear una fila nueva por cada modificación. Si cambia una columna que no necesitamos historificar, puede que no sea necesario abrir otra versión.
Este parámetro nos permite controlar qué atributos provocan realmente una nueva versión.
Además, evita un detalle fácil de pasar por alto: si dejamos que Auto CDC rastree todas las columnas del destino, la propia columna version puede provocar una versión nueva con cada evento.
4. Primera carga: nuestros clientes llegan al sistema
Vamos a comenzar con dos clientes.
Creamos el directorio de entrada y añadimos el primer archivo:
mkdir -p /tmp/demo_scd2/eventos

cat > /tmp/demo_scd2/eventos/batch1.json <<'EOF'
{"customer_id":17,"name":"Ana","region":"Norte","status":"activo","version":10,"op":"UPSERT"}
{"customer_id":23,"name":"Luis","region":"Centro","status":"activo","version":11,"op":"UPSERT"}
EOF
Con un catálogo compatible y la configuración de la pipeline completada, ejecutaríamos:
spark-pipelines runLa tabla histórica tendría este aspecto, omitiendo algunas columnas para facilitar la lectura:
| customer_id | region | __START_AT | __END_AT |
|---|---|---|---|
| 17 | Norte | 10 | NULL |
| 23 | Centro | 11 | NULL |
Observamos dos columnas nuevas:
__START_AT: secuencia a partir de la cual la versión es válida.__END_AT: secuencia en la que deja de ser válida.
Estas columnas las genera automáticamente Auto CDC.
Cuando __END_AT es NULL, significa que esa versión continúa vigente.
Hasta aquí no hemos hecho nada especialmente complicado. Tenemos dos clientes y una versión para cada uno.
Vamos a complicar un poco las cosas.
5. Segunda carga: una actualización y una eliminación
Ahora recibimos dos nuevos eventos.
Ana cambia a la región Sur y Luis deja de estar en nuestra base de clientes.
cat > /tmp/demo_scd2/eventos/batch2.json <<'EOF'
{"customer_id":17,"name":"Ana","region":"Sur","status":"activo","version":30,"op":"UPSERT"}
{"customer_id":23,"name":"Luis","region":"Centro","status":"activo","version":25,"op":"DELETE"}
EOF
Después de procesar este archivo, el historial esperado será:
| customer_id | region | __START_AT | __END_AT |
|---|---|---|---|
| 17 | Norte | 10 | 30 |
| 17 | Sur | 30 | NULL |
| 23 | Centro | 11 | 25 |
Fijémonos en Ana.
Su primer registro no se ha eliminado. Simplemente se ha cerrado estableciendo __END_AT = 30, y se ha creado otra versión con la región Sur.
En el caso de Luis ocurre algo diferente.
El evento DELETE cierra su registro en la secuencia 25, pero no crea una nueva versión.
Por eso Luis sigue apareciendo en nuestra tabla histórica, aunque ya no exista una versión activa de ese cliente.
Eliminar un registro del sistema de origen no tiene por qué significar perder su historial en nuestro modelo analítico.
6. El caso interesante: un evento llega tarde
Hasta ahora todos los eventos han llegado ordenados.
Pero imaginemos que, por algún problema en la entrega de mensajes, recibimos ahora una actualización anterior a la última modificación de Ana.
Resulta que había pasado por la región Este antes de trasladarse al Sur.
El sistema nos envía ahora el evento de la secuencia 20, cuando ya habíamos procesado la secuencia 30.
Añadimos también una nueva cliente, Marta:
cat > /tmp/demo_scd2/eventos/batch3.json <<'EOF'
{"customer_id":17,"name":"Ana","region":"Este","status":"activo","version":20,"op":"UPSERT"}
{"customer_id":31,"name":"Marta","region":"Oeste","status":"activo","version":35,"op":"UPSERT"}
EOF
¿Qué debería ocurrir?
Si estuviéramos procesando los cambios únicamente por orden de llegada, podríamos terminar con la región Este como último valor de Ana.
Sin embargo, la secuencia 20 es anterior a la 30.
Con Auto CDC y SCD Type 2, el evento se coloca en el intervalo histórico que le corresponde.
El resultado esperado sería:
| customer_id | region | __START_AT | __END_AT |
|---|---|---|---|
| 17 | Norte | 10 | 20 |
| 17 | Este | 20 | 30 |
| 17 | Sur | 30 | NULL |
| 23 | Centro | 11 | 25 |
| 31 | Oeste | 35 | NULL |
Ahora sí tenemos el historial completo.
Ana perteneció a Norte, después a Este y finalmente a Sur.
Y lo hemos reconstruido a pesar de que el evento de la región Este llegó cuando ya habíamos procesado el de Sur.
En un entorno real, este tipo de comportamiento es especialmente útil cuando los eventos llegan desde varias particiones, se producen reintentos o existe un retraso entre el origen de los datos y su procesamiento.
7. ¿Y si recibimos el mismo evento dos veces?
Hay otro escenario que conviene probar antes de dar por terminada nuestra pipeline: los eventos duplicados.
Imaginemos que el sistema vuelve a enviarnos exactamente el cambio de Ana correspondiente a la secuencia 20.
{
  "customer_id": 17,
  "name": "Ana",
  "region": "Este",
  "status": "activo",
  "version": 20,
  "op": "UPSERT"
}
No queremos generar una nueva versión histórica. Ese cambio ya está registrado.
Auto CDC contempla la recepción repetida de eventos y evita crear otra versión cuando vuelve a recibir el mismo cambio con su secuencia correspondiente.
En nuestro ejemplo, el historial de Ana debería permanecer exactamente igual:
| region | __START_AT | __END_AT |
|---|---|---|
| Norte | 10 | 20 |
| Este | 20 | 30 |
| Sur | 30 | NULL |
Esto es importante porque, en muchos sistemas de streaming, los mensajes pueden volver a procesarse después de determinados fallos o reintentos.
Eso sí, existe una diferencia entre recibir dos veces el mismo evento y recibir dos eventos distintos con la misma clave y el mismo número de secuencia.
Si dos cambios diferentes comparten exactamente la misma secuencia, Auto CDC no puede determinar de forma fiable cuál ocurrió primero.
Por eso, aunque el framework nos ayude con los duplicados, seguimos necesitando diseñar correctamente el campo que utilizamos para ordenar los eventos.
8. No todos los cambios necesitan una nueva versión histórica
Hasta ahora hemos visto cómo conservar todas las regiones por las que ha pasado Ana.
Pero imaginemos otro caso.
Ana continúa perteneciendo a la región Sur y sigue teniendo el estado activo. Lo único que cambia es su nombre, que ahora aparece como «Ana María».
Recibimos el siguiente evento:
{
  "customer_id": 17,
  "name": "Ana María",
  "region": "Sur",
  "status": "activo",
  "version": 40,
  "op": "UPSERT"
}
Recordemos que habíamos configurado nuestra pipeline así:
track_history_column_list=["region", "status"]Por tanto, solamente los cambios en region o status deben generar una nueva versión.
Como ninguno de esos dos atributos ha cambiado, Auto CDC puede actualizar el nombre dentro de la versión existente, sin abrir un nuevo intervalo histórico.
La versión activa de Ana seguiría empezando en la secuencia 30:
| name | region | __START_AT | __END_AT |
|---|---|---|---|
| Ana María | Sur | 30 | NULL |
Esto puede parecer un detalle pequeño, pero tiene implicaciones importantes.
Supongamos que tenemos millones de clientes y recibimos actualizaciones constantes de columnas técnicas que no aportan valor histórico.
Si cada actualización genera una fila nueva, nuestra tabla puede crecer considerablemente sin necesidad.
Seleccionar correctamente las columnas que queremos historificar ayuda a evitar ese problema.
Pero también debemos conocer la contrapartida: al no rastrear los cambios del nombre, no podremos reconstruir de manera fiable todos los nombres anteriores.
Si posteriormente necesitamos saber cuándo Ana pasó a llamarse Ana María, no tendremos esa transición representada como una versión histórica independiente.
Por eso, la elección de columnas debe responder a necesidades de negocio y no únicamente a criterios de rendimiento.
9. Consultando el historial
Una vez construida nuestra dimensión, podemos utilizarla desde SQL.
Por ejemplo, para recuperar solamente los registros activos:
SELECT
    customer_id,
    name,
    region,
    status
FROM dim_clientes
WHERE __END_AT IS NULL;
El resultado, después de todos los eventos anteriores, sería:
| customer_id | name | region | status |
|---|---|---|---|
| 17 | Ana María | Sur | activo |
| 31 | Marta | Oeste | activo |
Luis no aparece porque su última versión quedó cerrada.
Ahora imaginemos que queremos saber qué clientes pertenecían a cada región en la secuencia 22.
SELECT
    customer_id,
    region
FROM dim_clientes
WHERE __START_AT <= 22
  AND (
      __END_AT > 22
      OR __END_AT IS NULL
  );
El resultado:
| customer_id | region |
|---|---|
| 17 | Este |
| 23 | Centro |
Aquí aparece una de las ventajas de conservar intervalos históricos.
Podemos reconstruir la información que era válida en un momento determinado, algo especialmente útil cuando trabajamos con dimensiones asociadas a operaciones, transacciones o eventos.
También conviene recordar que los intervalos son semiabiertos: incluyen __START_AT, pero no __END_AT.
De esta forma, cuando una versión termina exactamente donde empieza la siguiente, no existen dos versiones válidas para el mismo instante.
10. Un caso real: cruzar las ventas con la región que tenía el cliente
Hasta ahora hemos estado jugando con una pequeña tabla de clientes.
Pero ¿para qué querríamos conservar todos esos cambios en un sistema analítico?
Imaginemos que tenemos una tabla de ventas:
| sale_id | customer_id | sale_date | amount |
|---|---|---|---|
| 1001 | 17 | 2026-01-15 | 150 |
| 1002 | 17 | 2026-02-20 | 300 |
| 1003 | 17 | 2026-03-18 | 200 |
El equipo comercial quiere conocer las ventas por región.
Podríamos hacer un join con la dimensión de clientes:
SELECT
    c.region,
    SUM(v.amount) AS total_ventas
FROM fact_ventas v
JOIN dim_clientes c
    ON v.customer_id = c.customer_id
WHERE c.__END_AT IS NULL
GROUP BY c.region;
¿Dónde está el problema?
Estamos utilizando la región actual del cliente para clasificar todas sus ventas, independientemente de cuándo ocurrieron.
Si Ana pertenecía a Norte en enero, Este en febrero y Sur en marzo, las tres operaciones acabarían asignándose a Sur.
El SQL funciona y probablemente nadie detecte el error a simple vista.
De hecho, este tipo de problemas pueden pasar desapercibidos durante bastante tiempo en un sistema de reporting.
La solución consiste en unir cada venta con la versión del cliente que estaba vigente en la fecha de la operación.
Para hacerlo, supongamos ahora que en nuestra pipeline utilizamos un timestamp de validez en sequence_by, en lugar del número entero del ejemplo anterior.
También asumimos que ese timestamp representa el instante efectivo del cambio para negocio, y no simplemente la hora en la que recibimos el mensaje.
Nuestra consulta sería:
SELECT
    c.region,
    SUM(v.amount) AS total_ventas
FROM fact_ventas v
JOIN dim_clientes c
    ON v.customer_id = c.customer_id
   AND v.sale_date >= c.__START_AT
   AND (
       v.sale_date < c.__END_AT
       OR c.__END_AT IS NULL
   )
GROUP BY c.region;
Ahora cada venta se asocia a la región que tenía el cliente en el momento en el que se produjo.
Si las versiones históricas son:
| region | __START_AT | __END_AT |
|---|---|---|
| Norte | 2026-01-01 | 2026-02-01 |
| Este | 2026-02-01 | 2026-03-01 |
| Sur | 2026-03-01 | NULL |
Obtendríamos:
| region | total_ventas |
|---|---|
| Norte | 150 |
| Este | 300 |
| Sur | 200 |
El resultado ahora sí representa lo que ocurrió realmente.
Este patrón se conoce como point-in-time join y resulta muy útil cuando trabajamos con dimensiones históricas.
Eso sí, hay que prestar especial atención a qué fecha estamos utilizando. La hora de procesamiento, la hora de commit y la fecha efectiva de un cambio no siempre coinciden.
Si queremos responder preguntas de negocio sobre el pasado, necesitamos que los intervalos históricos representen correctamente esa realidad.
11. Cómo comprobar que nuestra SCD Type 2 no contiene errores
Que una pipeline termine correctamente no significa necesariamente que los datos sean correctos.
En una SCD Type 2 hay varios controles que merece la pena automatizar.
Comprobar que solamente existe una versión activa por cliente
No deberíamos tener dos versiones actuales del mismo cliente.
Podemos detectarlo con una consulta muy sencilla:
SELECT
    customer_id,
    COUNT(*) AS versiones_activas
FROM dim_clientes
WHERE __END_AT IS NULL
GROUP BY customer_id
HAVING COUNT(*) > 1;
Lo esperado es que no devuelva ninguna fila.
Si aparece algún cliente, tenemos un problema: existen varias versiones que se consideran actuales al mismo tiempo.
Detectar intervalos históricos solapados
También debemos comprobar que las fechas o secuencias de una versión no se solapen con las de la siguiente.
Podemos hacerlo utilizando la función de ventana LEAD.
WITH historial AS (
    SELECT
        customer_id,
        __START_AT,
        __END_AT,
        LEAD(__START_AT) OVER (
            PARTITION BY customer_id
            ORDER BY __START_AT
        ) AS siguiente_inicio
    FROM dim_clientes
)

SELECT *
FROM historial
WHERE __END_AT IS NOT NULL
  AND siguiente_inicio IS NOT NULL
  AND __END_AT > siguiente_inicio;
Esta consulta busca clientes cuya versión actual termina después de que ya haya comenzado la siguiente.
Por ejemplo, sería incorrecto encontrarnos con algo así:
| customer_id | region | __START_AT | __END_AT |
|---|---|---|---|
| 17 | Norte | 10 | 25 |
| 17 | Este | 20 | 30 |
Entre las secuencias 20 y 25 tendríamos dos regiones válidas para el mismo cliente.
Por otro lado, no todos los huecos entre versiones son errores. Si un cliente fue eliminado y posteriormente volvió a crearse, es normal que exista un intervalo en el que no había ninguna versión activa.
Comprobar intervalos imposibles
Por último, podemos buscar versiones cuya fecha de cierre sea anterior o igual a la de apertura:
SELECT *
FROM dim_clientes
WHERE __END_AT <= __START_AT;
En condiciones normales, tampoco debería devolver resultados.
Estas comprobaciones son relativamente sencillas de incorporar a nuestros procesos de calidad de datos.
Y, aunque Auto CDC se encargue de mantener el historial, siguen siendo útiles para detectar problemas de configuración, datos inesperados o errores en nuestros procesos de integración.
12. ¿Y cómo lo hacíamos antes con MERGE?
Aquí viene la comparación interesante.
Tradicionalmente, una implementación de SCD Type 2 sobre un formato con soporte para operaciones de fila requería gestionar explícitamente los cambios.
En un caso sencillo, podríamos crear nuestra propia tabla histórica:
CREATE TABLE dim_clientes_manual (
    customer_id INT,
    name STRING,
    region STRING,
    status STRING,
    valid_from BIGINT,
    valid_to BIGINT
) USING iceberg;
Para aplicar los cambios, necesitaríamos al menos dos operaciones: cerrar las versiones anteriores e insertar las nuevas.
Supongamos que ya tenemos una tabla o vista cambios_nuevos, con un evento por cliente, ordenado correctamente respecto a los datos procesados.
Podríamos cerrar las versiones anteriores mediante:
MERGE INTO dim_clientes_manual AS t
USING cambios_nuevos AS s
ON t.customer_id = s.customer_id
   AND t.valid_to IS NULL

WHEN MATCHED
  AND s.version > t.valid_from
  AND (
      s.op = 'DELETE'
      OR NOT (t.region <=> s.region)
      OR NOT (t.status <=> s.status)
  )
THEN UPDATE SET
    t.valid_to = s.version;
La expresión <=> es una comparación de igualdad que trata correctamente los valores nulos en Spark SQL.
Con este MERGE cerramos los registros activos cuando llega una eliminación o cambia alguno de los atributos que estamos rastreando.
Después tendríamos que insertar las nuevas versiones.
INSERT INTO dim_clientes_manual
SELECT
    s.customer_id,
    s.name,
    s.region,
    s.status,
    s.version AS valid_from,
    CAST(NULL AS BIGINT) AS valid_to
FROM cambios_nuevos AS s
WHERE s.op = 'UPSERT'
  AND NOT EXISTS (
      SELECT 1
      FROM dim_clientes_manual AS t
      WHERE t.customer_id = s.customer_id
        AND t.valid_to IS NULL
  );
Estas dos sentencias ilustran la mecánica básica para un flujo simplificado, con un evento nuevo por cliente, cambios procesados en orden y sin reintentos. No son una implementación completa y segura para producción.
¿Dónde empiezan las complicaciones?
Pensemos en el evento tardío de Ana.
Su versión actual empieza en la secuencia 30. El evento que acabamos de recibir corresponde a la secuencia 20.
Nuestro MERGE no puede limitarse a cerrar la versión activa: tendría que localizar el intervalo entre 10 y 30, modificar su límite superior e insertar una versión intermedia.
Y si además recibimos duplicados, eliminaciones antiguas o varias actualizaciones del mismo cliente en un único lote, la lógica se complica todavía más.
Necesitaríamos incorporar deduplicación, gestión de intervalos, control de secuencias y mecanismos de recuperación ante fallos.
Esto no significa que implementar una SCD Type 2 con MERGE sea una mala opción.
De hecho, puede ser perfectamente razonable en pipelines batch donde recibimos una única versión de cada registro por ejecución y tenemos controlado el orden de los cambios.
Pero cuando trabajamos con un flujo continuo de eventos CDC, desarrollar y mantener toda esta lógica implica un esfuerzo adicional considerable.
Y conviene aclarar algo: Auto CDC sigue utilizando operaciones MERGE internamente.
La diferencia no está en que haya descubierto una forma completamente nueva de almacenar datos, sino en que nos permite declarar las reglas y delegar en el motor gran parte de la lógica necesaria para aplicarlas.
13. Algunas cosas que conviene tener en cuenta antes de usarlo en producción
Aunque la API sea bastante cómoda, hay varias decisiones que siguen siendo responsabilidad nuestra.
La secuencia debe identificar correctamente el orden de los cambios
Si utilizamos un timestamp y varios eventos del mismo cliente comparten exactamente el mismo valor, el resultado puede no ser determinista.
En estos casos puede ser preferible construir una secuencia compuesta.
Por ejemplo, utilizando un timestamp de commit junto a un número de secuencia de la transacción.
La expresión de secuencia tampoco puede devolver valores nulos ni cambiar de tipo entre ejecuciones incrementales.
Necesitamos un formato y un catálogo compatibles
Auto CDC requiere un destino que implemente operaciones de fila mediante Data Source V2. No funciona directamente sobre una tabla Parquet convencional.
Además, el catálogo debe mantener sus metadatos entre ejecuciones. Una configuración que solamente existe durante la sesión de Spark no sirve para una pipeline incremental persistente.
En el momento de escribir este artículo, la compatibilidad de algunos conectores con Spark 4.3 todavía está evolucionando, así que merece la pena comprobar las versiones antes de preparar un entorno.
Cambiar las claves o el seguimiento histórico no es una modificación trivial
La configuración forma parte del estado de la pipeline.
Cambiar las claves de negocio, pasar de SCD Type 1 a Type 2 o modificar qué columnas generan historial puede requerir una reconstrucción completa del destino.
Spark dispone de opciones de full refresh, pero conviene recordar que reconstruir una dimensión histórica grande puede ser una operación costosa.
No deberíamos confundir la hora de llegada con la hora del cambio
Este punto es especialmente importante cuando trabajamos con eventos tardíos.
Imaginemos que un cliente cambia de región el lunes, pero el mensaje llega el miércoles.
Si utilizamos la hora de ingesta como secuencia, el sistema puede considerar que el cambio ocurrió el miércoles.
Sin embargo, para determinados análisis de negocio, necesitamos reflejar que la modificación fue efectiva desde el lunes.
Por eso debemos decidir qué concepto temporal queremos representar: el instante de transacción, la fecha efectiva del cambio o la hora de procesamiento.
Auto CDC ordena según la secuencia que le proporcionamos. No puede adivinar cuál de esas fechas es la correcta para nuestro negocio.
¿Y el rendimiento?
Reducir el código de nuestra pipeline no significa necesariamente que el procesamiento sea más barato.
Auto CDC necesita mantener información sobre los cambios y realizar operaciones de actualización sobre el destino.
En tablas grandes, esas operaciones pueden tener un coste considerable, especialmente si existen muchos cambios sobre las mismas claves o si el formato necesita reescribir archivos.
Antes de utilizarlo en una pipeline de producción, mediría como mínimo:
- El tiempo de procesamiento de cada lote.
- El número de registros modificados por ejecución.
- El crecimiento de la tabla histórica.
- La cantidad de archivos generados y las necesidades de compactación.
También compararía el coste con una implementación manual ya existente.
La API puede ser más sencilla, pero eso no sustituye una prueba de rendimiento con datos representativos.
El historial no elimina la necesidad de comprobar la calidad de los datos
Auto CDC puede ordenar correctamente los cambios que recibe, pero no puede solucionar por sí solo un CDC incompleto.
Si perdemos eventos en el sistema de origen, elegimos mal la clave de negocio o no tenemos una secuencia fiable, nuestro historial también será incorrecto.
Un modelo histórico sigue necesitando validaciones, controles de integridad y monitorización.
14. ¿Merece la pena utilizar Auto CDC?
Después de revisar esta funcionalidad, creo que su mayor ventaja no es simplemente reducir el número de líneas de código.
Lo interesante es poder expresar un problema bastante complicado mediante una configuración declarativa.
En lugar de programar cómo actualizar y cerrar cada registro, definimos las reglas:
- Qué identifica a una entidad.
- Cómo se ordenan sus cambios.
- Qué eventos representan eliminaciones.
- Qué atributos deben conservar historial.
Y dejamos que Spark se encargue de mantener las versiones.
Esto no significa que tengamos que sustituir todas nuestras implementaciones actuales de SCD Type 2.
Si tenemos una pipeline batch sencilla, una solución probada con MERGE puede seguir siendo la mejor alternativa.
Pero para arquitecturas incrementales que reciben eventos CDC, especialmente cuando tenemos que gestionar mensajes duplicados, eliminaciones y cambios fuera de orden, Auto CDC ofrece una opción bastante atractiva.
Además, con Spark 4.3, esta funcionalidad ya forma parte del ecosistema open source de Apache Spark, y no es simplemente una característica exclusiva de una plataforma comercial.
Personalmente, lo que más interesante me parece es la gestión de los eventos tardíos. Mantener el estado actual de una tabla no suele ser demasiado complicado. Lo difícil es reconstruir correctamente lo que ocurrió entre medias.
Y ahí es precisamente donde SCD Type 2 demuestra su utilidad.
Al final, una buena plataforma de datos no debería ser capaz únicamente de decirnos qué está pasando ahora.
También debería permitirnos entender qué ocurrió antes, cuándo cambió y por qué nuestros datos eran diferentes en aquel momento.