Imagina que tenemos una tabla con 500 millones de registros almacenados en Parquet.
Una mañana recibimos una petición bastante habitual: hay que eliminar unos cuantos registros incorrectos y actualizar el estado de varios pedidos.
En una base de datos tradicional no nos lo pensaríamos demasiado. Un par de sentencias SQL y problema resuelto.
Pero cuando trabajamos con archivos Parquet almacenados en S3, Azure Blob Storage o cualquier otro sistema de almacenamiento, las cosas no son tan sencillas.
Parquet es un formato columnar optimizado para lectura analítica, pero no está diseñado para modificar una fila individual como lo haríamos en una base de datos transaccional.
Entonces, ¿qué ocurre cuando ejecutamos esto?
DELETE FROM pedidos
WHERE id = 12345;
¿Se abre el archivo Parquet y desaparece esa fila? ¿Se vuelve a escribir el archivo completo? ¿Y qué pasa si queremos consultar los datos que teníamos antes de ejecutar el DELETE?
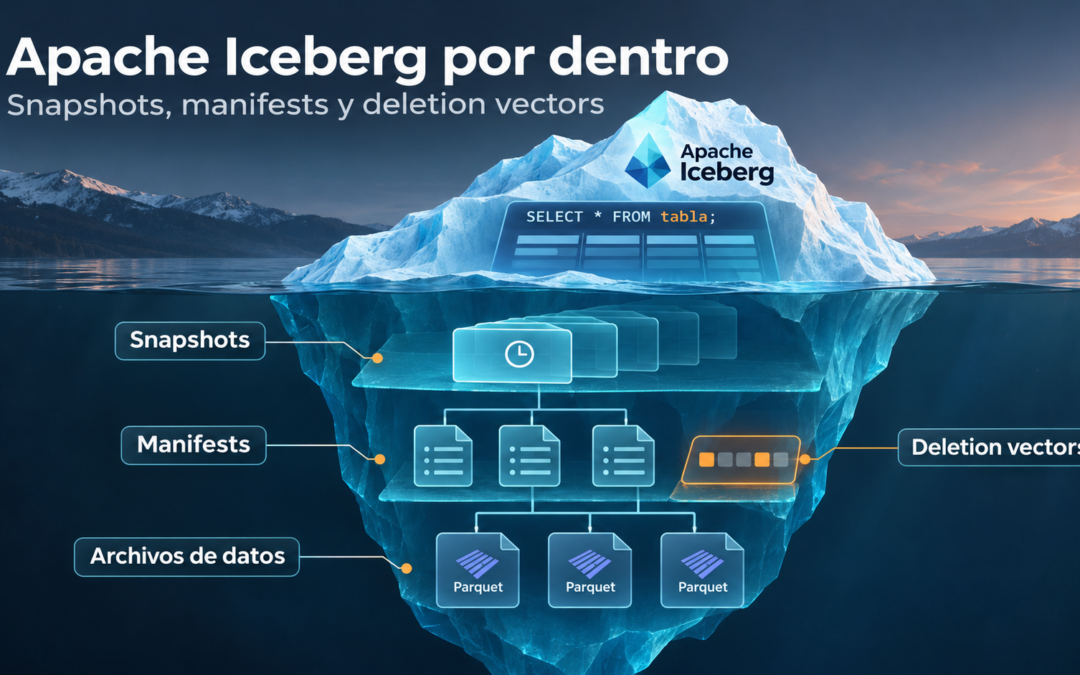
Todas estas preguntas nos llevan a una parte de Apache Iceberg que me parece especialmente interesante: cómo gestiona los archivos físicos y sus metadatos para ofrecer operaciones transaccionales sobre un Data Lake.
En este artículo vamos a ir un poco más allá de las consultas SQL. Vamos a crear una tabla Iceberg, modificarla y observar qué sucede en sus archivos de datos, manifests y snapshots.
También veremos qué aportan los deletion vectors de Iceberg V3 y por qué la compactación sigue siendo necesaria.
1. Antes de empezar: Iceberg no es un formato de archivo
Lo primero que conviene aclarar es una confusión bastante habitual.
Apache Iceberg no sustituye a Parquet. Son dos cosas diferentes.
Parquet se encarga de almacenar físicamente los registros, mientras que Iceberg gestiona cómo se organizan esos archivos para que podamos tratarlos como una tabla.
Una tabla Iceberg puede utilizar Parquet, ORC o Avro para almacenar sus datos.
La parte realmente interesante está en los metadatos.
Podemos imaginar su estructura de esta manera:
                   Catálogo
                      |
                      v
              metadata.json
                      |
                      v
                   Snapshot
                      |
                      v
                Manifest List
                      |
                      v
                Manifest Files
                      |
              +-------+-------+
              |               |
              v               v
        data-001.parquet  data-002.parquet
Este esquema está simplificado, pero nos sirve para entender las diferentes capas.
Metadata JSON
Contiene información sobre la tabla: esquema, propiedades, particionado, snapshots y referencias.
El catálogo mantiene una referencia a la versión actual de estos metadatos.
Snapshots
Representan estados consistentes de la tabla. Cada operación que modifica los datos puede generar un nuevo snapshot.
Manifest List
Identifica los manifests asociados a un snapshot y contiene información útil para planificar las lecturas.
Manifest Files
Son archivos, normalmente Avro en las versiones V1, V2 y V3 del formato, que contienen referencias y estadísticas de los archivos de datos o de eliminación.
Data Files
Son los archivos que contienen nuestros registros. En nuestro laboratorio utilizaremos Parquet.
Esta separación permite algo fundamental: modificar el estado lógico de una tabla sin tener que sobrescribir todos sus archivos físicos.
Y ahora vamos a verlo.
2. Preparando nuestro laboratorio con Spark e Iceberg 1.12
Para este ejemplo utilizaremos:
- Apache Spark 4.1
- Apache Iceberg 1.12.0
- Spark SQL
- Un catálogo local de tipo Hadoop
- Archivos Parquet
Iceberg 1.12.0 se publicó el 29 de septiembre de 2026 e incorporó mejoras en lectura, planificación de consultas, deletion vectors y mantenimiento de tablas.
Aunque Spark 4.3 ya está disponible, Iceberg 1.12 ofrece soporte oficial para Spark 3.5, 4.0 y 4.1. Por eso utilizaremos Spark 4.1 para evitar problemas de compatibilidad.
Instalación
Si todavía no tenemos Spark instalado, podemos preparar un entorno Python:
python -m venv .venv
source .venv/bin/activate

pip install pyspark==4.1.0
Necesitaremos también una instalación de Java compatible con nuestra versión de Spark.
Ahora creamos un directorio para nuestro warehouse:
mkdir -p /tmp/iceberg-labY arrancamos Spark SQL con las dependencias de Iceberg:
spark-sql \
  --packages org.apache.iceberg:iceberg-spark-runtime-4.1_2.13:1.12.0 \
  --conf spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions \
  --conf spark.sql.catalog.lab=org.apache.iceberg.spark.SparkCatalog \
  --conf spark.sql.catalog.lab.type=hadoop \
  --conf spark.sql.catalog.lab.warehouse=file:///tmp/iceberg-lab \
  --conf spark.sql.defaultCatalog=lab
Hemos creado un catálogo llamado lab que almacenará las tablas dentro de /tmp/iceberg-lab.
Es una configuración sencilla para experimentar. En producción normalmente utilizaríamos un catálogo REST, AWS Glue, Hive Metastore u otra implementación compatible.
3. Creando nuestra primera tabla Iceberg
Vamos a utilizar una tabla de pedidos con tres columnas:
CREATE NAMESPACE IF NOT EXISTS lab.demo;

CREATE TABLE lab.demo.pedidos_cow (
    id BIGINT,
    estado STRING,
    importe DECIMAL(10,2)
)
USING iceberg
TBLPROPERTIES (
    'format-version' = '2',
    'write.delete.mode' = 'copy-on-write',
    'write.update.mode' = 'copy-on-write',
    'write.merge.mode' = 'copy-on-write'
);
De momento utilizaremos la versión 2 del formato y configuraremos las operaciones en modo copy-on-write.
Más adelante crearemos otra tabla con formato V3 y merge-on-read para estudiar los deletion vectors.
Insertamos nuestros primeros registros:
INSERT INTO lab.demo.pedidos_cow
VALUES
    (101, 'creado', 29.90),
    (102, 'creado', 49.90),
    (103, 'creado', 19.90);
Añadimos otros dos pedidos en operaciones independientes:
INSERT INTO lab.demo.pedidos_cow
VALUES (104, 'creado', 89.00);

INSERT INTO lab.demo.pedidos_cow
VALUES (105, 'creado', 12.50);
Si consultamos la tabla:
SELECT *
FROM lab.demo.pedidos_cow
ORDER BY id;
Obtendremos cinco registros.
Hasta aquí nada sorprendente.
Pero ahora vamos a mirar algo que normalmente no vemos cuando trabajamos con una tabla SQL.
¿Qué archivos se han creado?
Abrimos otra terminal y ejecutamos:
find /tmp/iceberg-lab/demo/pedidos_cow \
  -type f | sort
Encontraremos archivos en dos directorios principales:
pedidos_cow/
│
├── data/
│   ├── ...parquet
│   ├── ...parquet
│   └── ...parquet
│
└── metadata/
    ├── ...metadata.json
    ├── snap-....avro
    └── ...-m0.avro
Los nombres reales son generados por Iceberg, por lo que no coincidirán exactamente con los del esquema.
Tampoco debemos asumir que cada INSERT crea un único archivo Parquet. El número depende del paralelismo de Spark, la distribución de los datos y la configuración de escritura.
Lo importante es que podemos distinguir dos tipos de información:
Los archivos Parquet almacenan los registros. Los archivos de metadata permiten que Iceberg sepa cuáles forman parte de cada versión de la tabla.
Para comprobarlo tenemos una herramienta bastante cómoda: las tablas de metadatos.
4. Los snapshots: cada operación tiene su propia versión
Iceberg permite consultar sus metadatos directamente desde SQL.
Por ejemplo:
SELECT
    committed_at,
    snapshot_id,
    parent_id,
    operation
FROM lab.demo.pedidos_cow.snapshots
ORDER BY committed_at;
Como hemos realizado tres inserciones independientes, deberíamos encontrar tres snapshots de escritura.
Cada uno tendrá un identificador diferente.
Un resultado ilustrativo sería:
| snapshot_id | parent_id | operation |
|---|---|---|
| 81001 | NULL | append |
| 81002 | 81001 | append |
| 81003 | 81002 | append |
Los identificadores reales son números largos generados por Iceberg.
Fijémonos en la columna parent_id.
Cada snapshot apunta al anterior, formando una cadena de estados.
Snapshot 81001
      |
      v
Snapshot 81002
      |
      v
Snapshot 81003
Aquí hay un detalle importante.
Un snapshot no es una copia completa de todos los datos de nuestra tabla.
Si cada inserción generase una copia física de los 500 millones de registros, el almacenamiento crecería de forma descontrolada.
En su lugar, los snapshots mantienen referencias a los archivos que pertenecen a cada estado.
Si un archivo no cambia entre dos snapshots, ambos pueden seguir haciendo referencia a él.
Esto permite que Iceberg conserve versiones históricas sin duplicar toda la tabla cada vez que hacemos una operación.
Time travel: consultar una versión anterior
Imaginemos que queremos recuperar el estado de nuestra tabla después de la primera inserción.
Podemos utilizar el identificador del primer snapshot:
-- Sustituir por el snapshot_id real
SELECT *
FROM lab.demo.pedidos_cow
VERSION AS OF 81001;
Obtendríamos únicamente los tres primeros pedidos:
| id | estado | importe |
|---|---|---|
| 101 | creado | 29.90 |
| 102 | creado | 49.90 |
| 103 | creado | 19.90 |
Los pedidos 104 y 105 todavía no existían en aquella versión.
Todo esto funciona porque Iceberg sabe qué archivos estaban activos en ese snapshot.
Conviene diferenciarlo de una SCD Type 2.
Una SCD2 conserva distintas versiones de los registros como parte del modelo de datos. Un snapshot de Iceberg representa un estado completo de la tabla en un momento determinado.
Son mecanismos diferentes y pueden utilizarse conjuntamente.
5. Los manifests: cómo sabe Iceberg qué archivos debe leer
Vamos a bajar otro nivel.
Cuando ejecutamos un SELECT, Spark necesita averiguar qué archivos contienen los datos que buscamos.
Podría recorrer todos los Parquet de nuestro almacenamiento, pero sería una estrategia bastante ineficiente.
Imaginemos una tabla con 200.000 archivos. Revisarlos todos cada vez que lanzamos una consulta sería un problema importante.
Aquí entran en juego los manifests.
Podemos inspeccionarlos:
SELECT
    path,
    length,
    added_snapshot_id,
    added_data_files_count,
    existing_data_files_count,
    deleted_data_files_count
FROM lab.demo.pedidos_cow.manifests;
Cada fila representa un manifest asociado al snapshot actual.
Estos manifests almacenan referencias a archivos de datos, junto con información como sus particiones, tamaños y estadísticas.
Podemos ir todavía más al detalle:
SELECT
    file_path,
    record_count,
    file_size_in_bytes
FROM lab.demo.pedidos_cow.data_files;
Aquí podemos ver los archivos Parquet que forman parte del estado actual de la tabla.
Y si queremos inspeccionar las entradas de los manifests:
SELECT
    status,
    snapshot_id,
    sequence_number,
    data_file.file_path AS file_path,
    data_file.record_count AS record_count
FROM lab.demo.pedidos_cow.entries;
En los manifests de Iceberg V2, el campo status identifica el estado de las entradas:
| Valor | Significado |
|---|---|
| 0 | EXISTING |
| 1 | ADDED |
| 2 | DELETED |
Este DELETED no debe confundirse con eliminar una fila mediante SQL.
Aquí estamos hablando de archivos que han dejado de pertenecer al estado de una tabla.
¿Por qué son tan importantes las estadísticas?
Supongamos que tenemos un archivo Parquet cuyos identificadores de pedido están entre 1 y 50.000.
Otro archivo contiene identificadores entre 50.001 y 100.000.
Y ejecutamos:
SELECT *
FROM lab.demo.pedidos_cow
WHERE id = 75000;
Si Iceberg dispone de estadísticas adecuadas, puede descartar archivos cuyos límites no permiten encontrar ese identificador.
No necesita abrirlos para comprobar cada registro.
A esto lo conocemos como file pruning.
Las estadísticas de los manifests y archivos ayudan al motor a reducir el trabajo necesario para ejecutar la consulta.
Eso sí, los límites mínimo y máximo no son un índice exacto. Si un archivo contiene los identificadores 1 y 100.000, puede parecer relevante para muchos valores intermedios aunque no los contenga.
Por eso la distribución física de los registros también influye en el rendimiento.
6. Ejecutamos un UPDATE: ¿qué ocurre realmente?
Ahora vamos a modificar uno de nuestros pedidos.
UPDATE lab.demo.pedidos_cow
SET estado = 'enviado'
WHERE id = 102;
Volvemos a consultar la tabla y comprobamos que el pedido 102 tiene el estado enviado.
Hasta aquí parece una operación normal.
Pero recordemos que configuramos:
'write.update.mode' = 'copy-on-write'Esto cambia bastante las cosas.
Copy-on-write: sustituir los archivos afectados
Cuando utilizamos copy-on-write, Iceberg no modifica directamente una fila dentro de un Parquet existente.
En términos generales, Spark realiza el siguiente proceso:
- Identifica los archivos que contienen registros afectados por el
UPDATE. - Lee esos archivos.
- Genera nuevos archivos con los cambios aplicados.
- Confirma una nueva versión de la tabla que hace referencia a los archivos nuevos.
Imaginemos que inicialmente tenemos este archivo:
data-001.parquet

101 | creado | 29.90
102 | creado | 49.90
103 | creado | 19.90
Después del UPDATE, podría generarse un archivo nuevo:
data-004.parquet

101 | creado  | 29.90
102 | enviado | 49.90
103 | creado  | 19.90
Y el nuevo snapshot dejaría de referenciar el archivo anterior.
ANTES

Snapshot A
    |
    v
data-001.parquet


DESPUÉS

Snapshot A             Snapshot B
    |                      |
    v                      v
data-001.parquet       data-004.parquet
Es un ejemplo simplificado, pero refleja bien el funcionamiento de copy-on-write.
Si varios archivos contienen registros afectados, podrían reescribirse varios archivos. Los que no estén afectados pueden mantenerse tal como estaban.
¿Ha desaparecido el archivo antiguo?
No necesariamente.
Puede que data-001.parquet siga existiendo físicamente en el almacenamiento.
El snapshot actual ya no lo utiliza, pero otro snapshot histórico podría seguir necesitándolo.
Esta es una de las claves del funcionamiento de Iceberg: dejar de utilizar un archivo y eliminarlo físicamente son dos operaciones diferentes.
Podemos comprobar qué archivos utiliza la versión actual:
SELECT file_path
FROM lab.demo.pedidos_cow.data_files;
Y compararlos con los que existían antes del UPDATE.
7. Ahora hacemos un DELETE
Vamos a eliminar el pedido 103:
DELETE FROM lab.demo.pedidos_cow
WHERE id = 103;
Como seguimos utilizando copy-on-write, el comportamiento será parecido al del UPDATE.
Spark identificará los archivos afectados y Iceberg confirmará una nueva versión de la tabla con los registros eliminados.
Podemos comprobarlo:
SELECT *
FROM lab.demo.pedidos_cow
ORDER BY id;
El pedido 103 ya no aparecerá.
Pero aquí surge una pregunta interesante.
Si solamente queremos eliminar un registro de un archivo con varios millones de filas, ¿tenemos que reescribir todo el archivo?
Con copy-on-write, puede ser necesario reescribir los archivos afectados, aunque solamente cambie una parte pequeña de su contenido.
Por eso existe otra estrategia: merge-on-read.
8. Copy-on-write vs. merge-on-read
Las dos estrategias persiguen el mismo objetivo: que nuestras consultas devuelvan los datos correctos.
La diferencia principal está en cuándo asumimos el coste de aplicar las modificaciones.
| Copy-on-write | Merge-on-read | |
|---|---|---|
| Escritura | Reescribe archivos afectados | Puede escribir eliminaciones sin reescribir inmediatamente los datos originales |
| Lectura | Lee datos ya materializados | Puede necesitar aplicar eliminaciones durante la lectura |
| Actualizaciones frecuentes | Puede resultar costoso | Puede reducir el trabajo de escritura |
| Mantenimiento | Requiere controlar archivos y metadatos | También necesita gestionar archivos de eliminación |
En general, copy-on-write tiene sentido cuando queremos optimizar las lecturas y las modificaciones no son demasiado frecuentes.
Por otro lado, merge-on-read puede resultar interesante en tablas donde recibimos actualizaciones y eliminaciones constantemente.
Pero tampoco significa que merge-on-read sea siempre más rápido.
Estamos trasladando parte del trabajo desde la escritura hacia la lectura.
Si acumulamos demasiados archivos de eliminación, nuestras consultas pueden acabar pagando ese coste.
Y aquí llegamos a uno de los conceptos más interesantes de Iceberg V3.
9. De los position deletes a los deletion vectors
En Iceberg V2, una forma de implementar eliminaciones sin reescribir los archivos originales es mediante position delete files.
Un position delete identifica una fila mediante dos elementos:
- El archivo de datos al que pertenece.
- La posición de esa fila dentro del archivo.
Por ejemplo:
Archivo: data-001.parquet
Posición eliminada: 1
Si la segunda fila del archivo corresponde al pedido 102, el motor sabe que debe ignorarla cuando lea los datos.
El archivo original puede permanecer intacto.
Sin embargo, si realizamos muchas eliminaciones, podemos terminar generando numerosos archivos de position deletes.
Y eso puede complicar las lecturas.
¿Qué cambia con los deletion vectors?
Con Iceberg V3 aparecen los deletion vectors (DV).
La idea es representar las posiciones eliminadas de un archivo mediante una estructura bitmap compacta.
Imaginemos un archivo con diez registros:
Posición    Estado
-------------------
0           Activo
1           Activo
2           Eliminado
3           Activo
4           Activo
5           Eliminado
6           Activo
7           Activo
8           Activo
9           Activo
Conceptualmente, el deletion vector podría representarse así:
0 0 1 0 0 1 0 0 0 0
    ^     ^
  borrar borrar
Esta representación es solamente didáctica. Los deletion vectors de Iceberg no se almacenan como una cadena de ceros y unos.
Utilizan estructuras bitmap comprimidas, basadas en Roaring Bitmap, para representar eficientemente posiciones de filas eliminadas.
En Iceberg V3 se almacenan como blobs dentro de archivos Puffin.
Puffin es un formato utilizado por Iceberg para almacenar determinados tipos de información auxiliar.
Una propiedad importante es que podemos tener varios deletion vectors dentro de un mismo archivo Puffin.
Además, cada deletion vector está asociado a un archivo de datos concreto.
La especificación establece que, para un snapshot, puede existir como máximo un deletion vector activo por archivo de datos.
Si llegan nuevas eliminaciones sobre ese archivo, el escritor debe consolidarlas con las anteriores.
Esto evita que el lector tenga que resolver una colección creciente de vectores independientes para el mismo archivo.
Entonces, ¿el registro sigue físicamente en Parquet?
Sí, puede seguir estando.
Lo que cambia es la forma en la que Iceberg interpreta ese archivo.
Al consultar la tabla, el lector combina los registros físicos con la información del deletion vector para excluir las posiciones eliminadas.
Es importante recordar que esto es una eliminación lógica.
El registro puede dejar de ser visible en la tabla sin desaparecer inmediatamente de los bytes almacenados en el archivo Parquet.
10. Probamos los deletion vectors con una tabla V3
Vamos a crear otra tabla para experimentar con este comportamiento.
CREATE TABLE lab.demo.pedidos_mor (
    id BIGINT,
    estado STRING,
    importe DECIMAL(10,2)
)
USING iceberg
TBLPROPERTIES (
    'format-version' = '3',
    'write.delete.mode' = 'merge-on-read',
    'write.update.mode' = 'merge-on-read',
    'write.merge.mode' = 'merge-on-read'
);
Esta vez utilizamos el formato V3 y activamos merge-on-read.
Insertamos algunos pedidos:
INSERT INTO lab.demo.pedidos_mor
VALUES
    (201, 'creado', 20.00),
    (202, 'creado', 35.00),
    (203, 'creado', 40.00),
    (204, 'creado', 65.00),
    (205, 'creado', 90.00);
Antes de eliminar nada, inspeccionamos los archivos de datos:
SELECT
    file_path,
    record_count,
    file_size_in_bytes
FROM lab.demo.pedidos_mor.data_files;
Ahora eliminamos un pedido:
DELETE FROM lab.demo.pedidos_mor
WHERE id = 202;
La tabla devolverá cuatro registros.
Pero, a diferencia de nuestro ejemplo anterior, no hemos pedido a Iceberg que reescriba los archivos afectados mediante copy-on-write.
En una operación merge-on-read de V3 que afecta parcialmente a un archivo, Spark e Iceberg pueden registrar las posiciones eliminadas mediante deletion vectors.
Podemos inspeccionar los metadatos de eliminación:
SELECT
    content,
    file_path,
    file_format,
    record_count
FROM lab.demo.pedidos_mor.delete_files;
Cuando se generan deletion vectors, encontraremos referencias a información almacenada en archivos Puffin.
El detalle es importante: una entrada de un deletion vector puede señalar un bloque concreto dentro de un Puffin, no necesariamente un archivo Puffin dedicado a una sola eliminación.
El campo record_count de esa entrada representa la cantidad de posiciones eliminadas que registra el vector.
Si examinamos el directorio físico, también podremos buscar los archivos Puffin:
find /tmp/iceberg-lab/demo/pedidos_mor \
  -type f -name "*.puffin"
Conviene tener presente que el resultado concreto depende del plan de escritura.
Si un DELETE elimina todos los registros de un archivo, Iceberg puede resolverlo mediante una operación sobre metadatos, sin necesidad de generar un deletion vector.
Por eso, para comprobar este mecanismo, necesitamos que la eliminación afecte solamente a algunas filas de un archivo que contenga otros registros válidos.
¿Qué ocurre si hacemos un UPDATE?
Probemos ahora:
UPDATE lab.demo.pedidos_mor
SET estado = 'enviado'
WHERE id = 203;
Una actualización sobre una tabla merge-on-read puede tratarse conceptualmente como dos acciones:
- Invalidar la versión anterior del registro.
- Escribir una nueva versión con los valores actualizados.
Por tanto, podríamos encontrar nuevos archivos de datos y nuevos metadatos de eliminación.
Lo interesante es que no necesitamos reescribir inmediatamente todos los registros originales del archivo afectado.
Pero esa comodidad tiene un precio: durante las lecturas tendremos que tener en cuenta qué posiciones están eliminadas.
11. Inspeccionando los metadatos de Iceberg
Hasta ahora hemos utilizado las tablas de metadatos desde Spark SQL.
Pero también podemos mirar directamente los archivos JSON.
Dentro del directorio metadata encontraremos archivos con nombres parecidos a:
00000-....metadata.json
00001-....metadata.json
00002-....metadata.json
Cada versión de los metadatos de tabla describe información como:
- El esquema y sus identificadores.
- Las propiedades configuradas.
- Los snapshots disponibles.
- El identificador del snapshot actual.
- Las referencias a branches y tags.
- El historial de cambios de metadata.
Podemos utilizar Python para inspeccionarlos:
import json
from pathlib import Path

metadata_dir = Path(
    "/tmp/iceberg-lab/demo/pedidos_mor/metadata"
)

files = sorted(
    metadata_dir.glob("*.metadata.json")
)

for path in files:
    with path.open() as f:
        metadata = json.load(f)

    print(f"\nArchivo: {path.name}")
    print("Formato:", metadata.get("format-version"))
    print("Snapshot actual:", metadata.get("current-snapshot-id"))
    print("Schema ID:", metadata.get("current-schema-id"))
Este pequeño script nos permite comprobar cómo evoluciona la información de la tabla después de cada operación.
Eso sí, no debemos asumir que el archivo JSON con el nombre más reciente es siempre el que utiliza la tabla.
El catálogo mantiene la referencia a la versión actual de metadata, y esa es la referencia que determina el estado vigente.
Esta distinción es especialmente importante cuando existen varios escritores trabajando simultáneamente.
¿Cómo se confirma una operación?
Imaginemos que dos procesos intentan actualizar la misma tabla a la vez.
Ambos parten de una versión determinada de los metadatos.
Cada uno prepara sus nuevos archivos y su propuesta de actualización.
Pero no pueden limitarse a sobrescribir el mismo archivo JSON y esperar que todo salga bien.
Iceberg utiliza mecanismos de commit optimista.
Simplificando, un escritor prepara una nueva versión y trata de confirmar que el catálogo apunte a ella de forma atómica.
Si otro escritor se ha adelantado, el segundo puede necesitar validar nuevamente su operación y reintentar el commit.
Esto evita que dos escrituras concurrentes se pisen silenciosamente.
No significa que cualquier combinación de operaciones concurrentes sea válida. Iceberg sigue necesitando comprobar conflictos entre las modificaciones, especialmente en operaciones que actualizan o eliminan registros.
12. El problema de los archivos pequeños
Vamos con otro problema bastante habitual en sistemas de datos.
Imaginemos que tenemos una pipeline de streaming que recibe datos cada minuto y escribe continuamente en una tabla Iceberg.
Cada lote puede generar nuevos archivos Parquet.
Después de varios días, podríamos encontrarnos con una tabla que contiene miles de archivos muy pequeños.
Y aunque el volumen total de datos no sea especialmente grande, el rendimiento de las consultas puede empeorar.
¿Por qué?
Porque abrir, planificar y procesar miles de archivos tiene un coste.
Además, cuantos más archivos tenga una tabla, más referencias tendrán que gestionar sus manifests.
Un archivo Parquet de 500 MB y mil archivos de 500 KB contienen aproximadamente la misma cantidad de datos, pero no necesariamente tienen el mismo coste de lectura.
Por eso es importante realizar tareas de mantenimiento.
Compactación de archivos de datos
Iceberg incorpora el procedimiento rewrite_data_files, que permite combinar archivos pequeños en archivos mayores.
Vamos a probarlo sobre nuestra tabla pedidos_cow:
CALL lab.system.rewrite_data_files(
    table => 'demo.pedidos_cow',
    options => map(
        'rewrite-all', 'true'
    )
);
Hemos activado rewrite-all para forzar la reescritura de los archivos seleccionados, ya que nuestra tabla de ejemplo tiene muy pocos registros.
En producción no utilizaríamos esta opción indiscriminadamente sobre tablas enormes.
Después de ejecutar la operación, podemos revisar los archivos activos:
SELECT
    file_path,
    record_count,
    file_size_in_bytes
FROM lab.demo.pedidos_cow.data_files;
El objetivo de la compactación es reducir la fragmentación de los archivos físicos.
También podemos consultar los snapshots:
SELECT
    snapshot_id,
    operation,
    committed_at
FROM lab.demo.pedidos_cow.snapshots
ORDER BY committed_at;
La compactación suele registrar una operación de tipo replace.
Esto significa que hemos cambiado la organización física de los datos sin alterar necesariamente el resultado lógico de la tabla.
Esa distinción es importante.
Una compactación no debería cambiar nuestros resultados analíticos. Debería cambiar la forma en la que almacenamos y recuperamos esos resultados.
En tablas merge-on-read, una reescritura de datos también puede materializar eliminaciones pendientes al generar nuevos archivos sin las filas borradas.
Así reducimos el trabajo que tendrán que realizar determinadas lecturas futuras.
13. Compactar datos no es lo mismo que compactar manifests
Ya hemos visto cómo reducir el número de archivos Parquet.
Pero podemos tener otro problema: demasiados manifests.
Recordemos que los manifests contienen referencias y estadísticas de los archivos utilizados por nuestra tabla.
En sistemas con escrituras frecuentes podemos terminar acumulando bastantes archivos de metadata.
Aunque los archivos Parquet tengan un tamaño adecuado, el motor puede dedicar demasiado tiempo a planificar qué archivos necesita leer.
Para mejorar esta situación, Iceberg dispone de otro procedimiento:
CALL lab.system.rewrite_manifests(
    table => 'demo.pedidos_cow'
);
Esta operación reorganiza los manifests.
No estamos cambiando los registros almacenados en Parquet, sino optimizando la estructura de metadata que Iceberg utiliza para localizar los archivos.
Podemos comparar el estado antes y después:
SELECT
    COUNT(*) AS total_manifests,
    SUM(length) AS total_bytes
FROM lab.demo.pedidos_cow.manifests;
Conviene aclarar que ejecutar rewrite_manifests no garantiza una mejora de rendimiento en cualquier tabla.
En un ejemplo pequeño como el nuestro, probablemente la diferencia sea irrelevante.
Tiene mucho más sentido en tablas grandes, particionadas y con numerosas operaciones de escritura.
¿Qué mejora Iceberg 1.12 en este apartado?
Iceberg 1.12 añade, entre otras mejoras, nuevas opciones para reorganizar manifests mediante criterios de ordenación en las versiones de Spark soportadas.
También incorpora mejoras de caché para los archivos manifest list.
Son optimizaciones que pueden resultar interesantes en tablas donde el tiempo de planificación representa una parte importante del tiempo total de consulta.
Y aquí aparece una conclusión que merece la pena recordar: no siempre el problema de una consulta lenta está en procesar millones de registros.
A veces una parte importante del tiempo se consume simplemente averiguando qué archivos hay que leer.
14. Time travel no significa almacenamiento infinito
Volvamos a nuestros snapshots.
Hemos realizado varias inserciones, actualizaciones, eliminaciones y compactaciones.
Por tanto, Iceberg mantiene distintas versiones históricas de nuestra tabla.
Pero ¿qué ocurre con los archivos antiguos?
Si cada compactación genera archivos nuevos y conservamos indefinidamente todos los anteriores, nuestro almacenamiento crecerá continuamente.
Por eso Iceberg incorpora procedimientos de mantenimiento como expire_snapshots.
Esta operación permite eliminar referencias a snapshots antiguos de acuerdo con una política de retención.
Cuando determinados archivos dejan de estar referenciados por cualquier snapshot o referencia que deba conservarse, pueden eliminarse físicamente.
Hay una consecuencia importante.
Después de expirar un snapshot, ya no podemos asumir que podremos recuperar aquella versión mediante time travel.
No es lo mismo conservar un historial de metadatos durante siete días que mantenerlo indefinidamente.
Además, los archivos que ya no están referenciados pueden no desaparecer automáticamente en todas las circunstancias.
Existen otras operaciones, como remove_orphan_files, destinadas a localizar archivos que no están referenciados por la tabla.
Pero hay que utilizarlas con cuidado, especialmente si existen escrituras en curso.
Una política de limpieza demasiado agresiva puede eliminar archivos que todavía necesitamos.
¿Y si necesitamos borrar datos personales?
Este punto merece especial atención.
Un DELETE lógico puede dejar de mostrar información en las consultas actuales, pero eso no garantiza que sus bytes hayan desaparecido físicamente del almacenamiento.
Puede haber archivos antiguos retenidos por snapshots históricos, branches, tags o políticas de recuperación.
Por tanto, si estamos eliminando información por motivos de privacidad o cumplimiento normativo, necesitamos una estrategia que contemple también la eliminación física, las políticas de retención y las posibles copias externas.
No basta con ejecutar un DELETE FROM y dar el trabajo por terminado.
15. Una comparación de mantenimiento: ¿qué deberíamos medir?
Si quisiéramos trasladar este laboratorio a una plataforma de producción, no me quedaría únicamente con comprobar que las consultas devuelven los datos correctos.
Me interesaría medir cómo evoluciona la tabla a medida que recibe cambios.
Podemos empezar con una consulta sencilla:
SELECT
    COUNT(*) AS total_archivos,
    SUM(file_size_in_bytes) AS bytes_totales,
    AVG(file_size_in_bytes) AS tamano_medio
FROM lab.demo.pedidos_cow.data_files;
Después podríamos revisar el número de manifests:
SELECT
    COUNT(*) AS total_manifests,
    SUM(length) AS bytes_metadata
FROM lab.demo.pedidos_cow.manifests;
Y, en una tabla con eliminaciones merge-on-read, consultar también sus delete files:
SELECT
    file_format,
    COUNT(*) AS total_referencias,
    SUM(record_count) AS posiciones_eliminadas
FROM lab.demo.pedidos_mor.delete_files
GROUP BY file_format;
Estas consultas nos ayudan a comprender cómo están evolucionando los archivos activos y las referencias de eliminación.
Eso sí, SUM(record_count) sobre los archivos de datos no equivale necesariamente al número de registros visibles en una tabla con deletion vectors.
Los Parquet pueden contener registros que están marcados como eliminados.
Para conocer cuántas filas devuelve realmente una tabla, debemos consultar la tabla lógica y aplicar las reglas de Iceberg:
SELECT COUNT(*)
FROM lab.demo.pedidos_mor;
Son dos métricas distintas y conviene no mezclarlas.
Qué compararía en un benchmark real
Para estudiar el comportamiento de copy-on-write y merge-on-read, prepararía dos tablas con el mismo conjunto de datos.
Después aplicaría un volumen equivalente de inserciones, actualizaciones y eliminaciones.
Mediría:
| Métrica | Qué queremos observar |
|---|---|
| Tiempo de escritura | Coste de aplicar cambios |
| Tiempo de lectura | Coste de resolver archivos y eliminaciones |
| Número de archivos | Fragmentación del almacenamiento |
| Tamaño de metadata | Sobrecarga de planificación |
| Tiempo de compactación | Coste del mantenimiento |
| Tamaño total almacenado | Crecimiento físico de la tabla |
También probaría distintos patrones de actualización.
No es lo mismo actualizar el 1 % de los registros, distribuidos entre miles de archivos, que modificar el 50 % de una partición completa.
En el primer caso, merge-on-read podría resultar especialmente interesante.
En el segundo, puede que la reescritura de archivos sea una alternativa perfectamente razonable.
Las conclusiones dependerán del volumen, la distribución de los cambios, la configuración del motor y el patrón de consultas.
Por eso no tiene demasiado sentido afirmar que una estrategia es siempre mejor que otra.
16. Algunas novedades interesantes de Iceberg 1.12
Para terminar, merece la pena repasar algunas mejoras de esta versión que están relacionadas con lo que hemos visto.
Conversión de equality deletes a deletion vectors en Flink
En determinados pipelines de streaming se utilizan equality deletes, que identifican registros a eliminar mediante los valores de una o varias columnas.
Son cómodos para determinadas escrituras, pero pueden implicar trabajo adicional en las lecturas.
Iceberg 1.12 incorpora una tarea de mantenimiento para Flink llamada ConvertEqualityDeletes.
Su objetivo es convertir equality deletes en deletion vectors sobre tablas V3.
De esta forma, las eliminaciones pueden resolverse por posición en lugar de tener que evaluar repetidamente las condiciones de igualdad durante las lecturas.
Es especialmente interesante para arquitecturas de streaming con muchas actualizaciones.
Mejoras en deletion vectors
La versión 1.12 también incorpora mejoras en el acceso a los deletion vectors y correcciones relacionadas con referencias compartidas dentro de archivos Puffin.
Aunque estas mejoras no se vean directamente desde SQL, son importantes para la fiabilidad del formato.
Más opciones para organizar los datos
Otra novedad interesante es el soporte de clustering mediante curvas de Hilbert en el procedimiento rewrite_data_files para Spark 4.1.
Al igual que Z-order, busca mejorar la organización física de los registros cuando filtramos por varias columnas.
El objetivo es que registros cercanos según determinadas dimensiones también se almacenen de forma próxima, facilitando que el motor descarte archivos irrelevantes.
No lo hemos incluido en este laboratorio porque requeriría preparar un conjunto de datos bastante mayor para observar diferencias relevantes.
Pero es un tema interesante para experimentar con tablas de cientos de millones de registros.
¿Y Iceberg V4?
Iceberg 1.12 también incluye trabajo preparatorio para el formato V4.
Entre otras cosas, se están desarrollando nuevas estructuras de manifests y mecanismos para asociar deletion vectors con los archivos que modifican.
Sin embargo, en esta versión V4 todavía no es un formato oficialmente adoptado que podamos utilizar para crear y operar tablas.
Por eso todos nuestros ejemplos se han centrado en V2 y V3.
17. Conclusiones: lo interesante de Iceberg está debajo del SQL
Después de revisar cómo funciona Iceberg, creo que una de sus características más interesantes es precisamente lo que no vemos cuando ejecutamos una consulta.
Desde Spark podemos utilizar operaciones bastante familiares:
INSERT INTO ...
UPDATE ...
DELETE FROM ...
MERGE INTO ...
Pero por debajo existe una estructura de metadatos que permite coordinar archivos Parquet, mantener versiones consistentes y aplicar modificaciones sin tener que reemplazar toda la tabla.
Los snapshots nos permiten reconstruir estados anteriores.
Los manifests ayudan a localizar qué archivos necesitamos leer.
Los deletion vectors permiten registrar eliminaciones a nivel de fila sin reescribir inmediatamente todos los datos.
Y la compactación evita que nuestra tabla termine acumulando una cantidad excesiva de archivos pequeños y metadatos fragmentados.
También hemos visto que estas funcionalidades tienen costes.
Con copy-on-write podemos terminar reescribiendo archivos relativamente grandes para modificar pocos registros.
Con merge-on-read podemos reducir ese trabajo durante las escrituras, pero añadir complejidad a las lecturas.
Y si mantenemos demasiados snapshots o no realizamos tareas de mantenimiento, el almacenamiento y los tiempos de planificación pueden crecer considerablemente.
En mi opinión, entender estas diferencias es bastante más útil que limitarse a aprender la sintaxis de las operaciones SQL.
Porque cuando una tabla empieza a recibir millones de registros diarios y el rendimiento se degrada, necesitamos saber qué está ocurriendo por debajo.
¿Estamos generando demasiados archivos pequeños? ¿Tenemos demasiados manifests? ¿Las consultas están teniendo que aplicar un número elevado de eliminaciones? ¿Estamos reescribiendo más datos de los necesarios?
Son preguntas que difícilmente podremos responder si solamente miramos el resultado de un SELECT.
Y es precisamente en esos momentos cuando comprender la arquitectura interna de Iceberg empieza a marcar la diferencia.